20 ноября 2026 года Thinking Machines Lab открыла веса модели Inkling 2 Mini — мультимодального looped transformer под лицензией Apache 2.0. Модель помещается в 32 ГБ памяти и демонстрирует сильные результаты на агентных и кодинг-бенчмарках, а независимое исследование Goodfire показало, что её архитектура остаётся интерпретируемой.

Что произошло
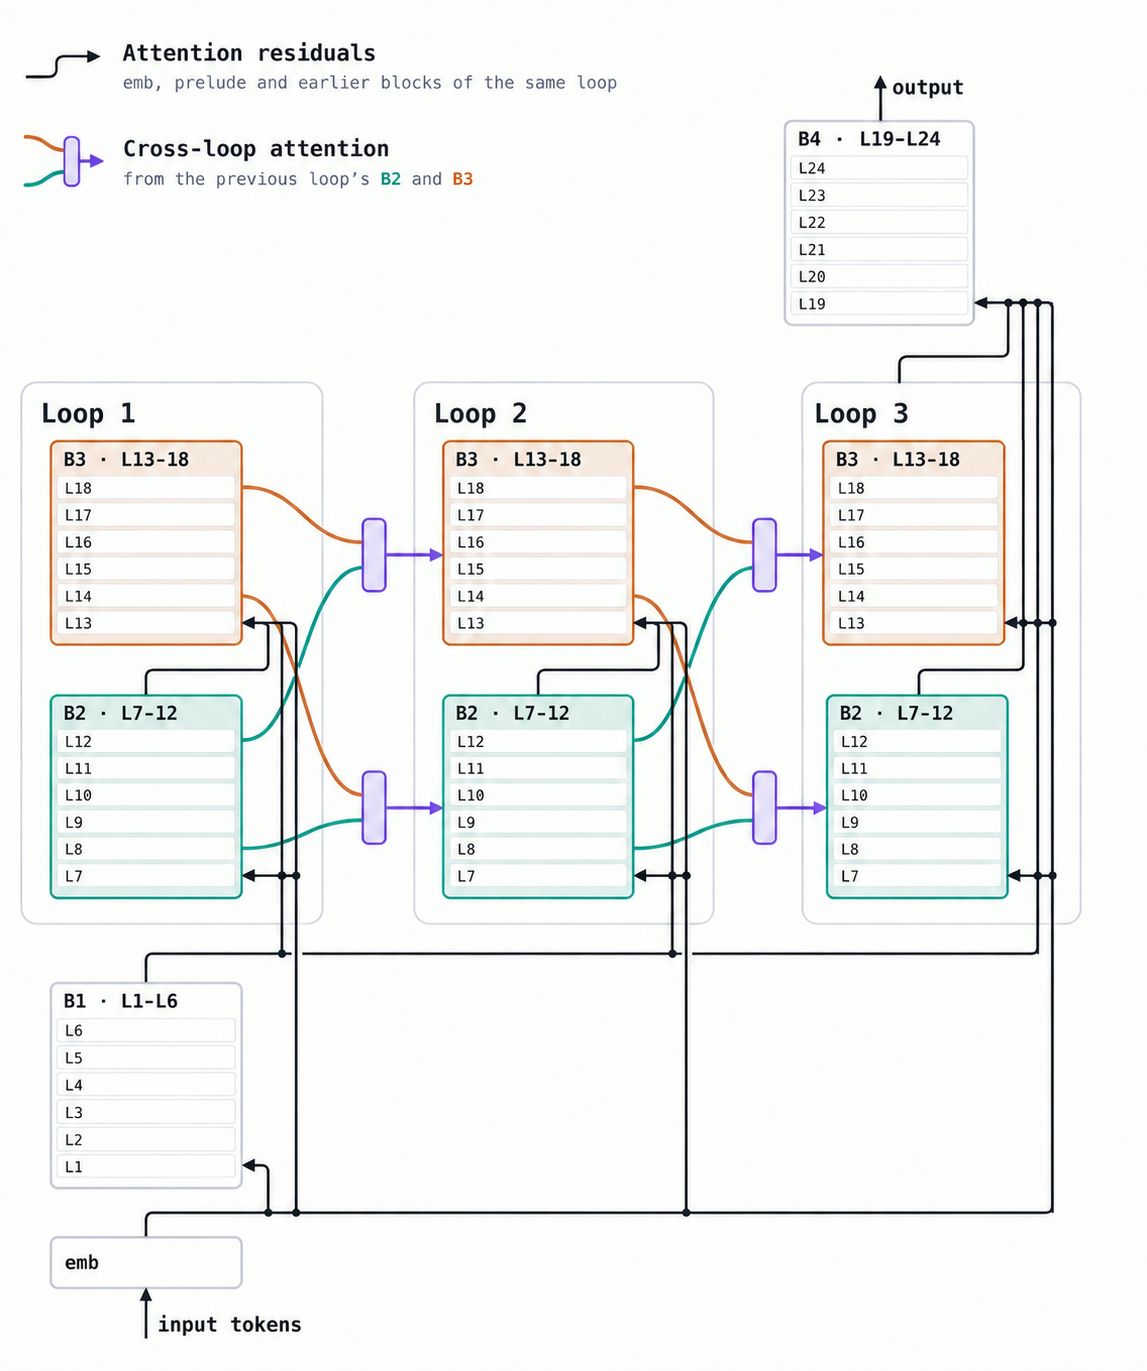
Thinking Machines Lab 20 ноября 2026 года опубликовала Inkling 2 Mini — открытую мультимодальную модель, принимающую на вход текст и изображения и выдающую текст, с лицензией Apache 2.0. Модель содержит 26,4B общих параметров, из которых активных 3,4B (5,4B эффективных на токен), поддерживает контекст до 1M токенов, её чекпоинт занимает около 20 ГБ, а запуск возможен на 32 ГБ VRAM или оперативной памяти, в том числе на DGX Spark и Apple Silicon. Это первый looped transformer лаборатории: архитектура состоит из 24 слоёв decoder-only MoE, где на каждый слой активируются 8 из 128 экспертов, а средние 12 слоёв (блоки 2 и 3) прогоняются трижды с общими весами; механизм cross-loop attention позволяет слоям читать выводы предыдущего витка. По заявленным бенчмаркам модель набирает SWEBench Verified 79,2%, BrowseComp 79,0%, OmniDocBench v1.6 92,8% и ARC-AGI v1/v2 84,5%/49,3%, превосходя Qwen3.8-27B и Gemma 4 31B в агентных и кодинг-задачах. В тот же день Goodfire опубликовал исследование интерпретируемости модели.
Контекст
В основе Inkling 2 Mini лежит подход, который называют «скейлингом глубины»: вычислительная глубина модели масштабируется повторным проходом тех же слоёв, а не добавлением новых параметров. В отличие от классических transformer, где увеличение глубины требует роста числа весов и размера чекпоинта, здесь один компактный набор весов прогоняется несколько раз, и слои последующих витков получают доступ к выводам предыдущих через cross-loop attention. Это делает глубину независимым от ширины и общего числа параметров ресурсом. Для понимания значимости релиза важно, что до Inkling 2 Mini публичных открытых looped transformer от крупных лабораторий не было: модель стала первым публичным примером этой архитектуры с открытыми весами.
Почему это важно для индустрии
Для отрасли Inkling 2 Mini задаёт референс архитектуры, в которой глубина становится самостоятельной осью масштабирования наряду с шириной и числом параметров. Повторный проход слоёв меняет экономику инференса: вместо десятков гигабайт параметров для глубокой модели достаточно одного чекпоинта около 20 ГБ, что делает локальный агентный инференс — кодинг, браузерные агенты, документную автоматизацию — доступным на доступном железе без облачных API. Открытая лицензия Apache 2.0 позволяет встраивать модель в коммерческие продукты без лицензионных ограничений, а готовая экосистема рантаймов снижает порог входа для стартапов. Отдельно важна проверка Goodfire: архитектура остаётся интерпретируемой — tuned-lens и coda-lens на ней работают, тогда как logit-lens — нет; единого residual stream нет, информация передаётся блоковыми суммами, а аномальные активации (координата d_2027, около 46% квадрата нормы) действуют как «теги», определяющие, какие блоки читают будущие витки. Это усиливает доверие к looped-моделям как к классу архитектур.
Почему это важно для пользователей
Практически Inkling 2 Mini можно запустить локально на 32 ГБ — на MacBook, Mac mini, Mac Studio, DGX Spark или GPU с 32 ГБ VRAM — через vLLM, SGLang, llama.cpp, Ollama, Unsloth (GGUF) или Llama App, а дообучать через Tinker. Это позволяет собрать прототип локального кодинг-агента или long-context RAG-продукта без облака и без лицензионных ограничений. При использовании стоит учитывать заявленные ограничения: модель склонна к зацикливанию в рассуждениях, поэтому нужны жёсткие лимиты токенов и итераций; качество деградирует на неанглийских языках, так что для русскоязычных сценариев без дообучения она не подходит; а тройной проход слоёв увеличивает вычислительные затраты на токен по сравнению с однократным проходом.
Что пока неизвестно / ограничения
Методология бенчмарков, условия прогона и размерность тестовых выборок в предоставленных материалах не описаны, поэтому заявленные результаты (SWEBench Verified 79,2%, ARC-AGI v1 84,5%) пока не подтверждены независимой проверкой. Для продакшена «из коробки» модель пока не готова: заявлены склонность к зацикливанию рассуждений и деградация качества на неанглийских языках. Производственные замеры latency, throughput и стоимости токена, а также оптимизации рантаймов под looped-паттерн ещё отсутствуют.
Источники
- thinkingmachines/Inkling-2-Mini — Model Card (Hugging Face)
- Interpreting Inkling 2 Mini — Goodfire Research
Автор
Look at AI, редакция